Enterprise w nazwie, chaos w architekturze.

Enterprise w nazwie, chaos w architekturze. Dlaczego SaaS wciąż nie rozumie bezpieczeństwa przedsiębiorstw?

Jest coś, co niezmiennie mnie zadziwia w branży IT.

Od lat uczymy się, jak projektować bezpieczne aplikacje. Rozmawiamy o RBAC, zasadzie najmniejszych uprawnień, separacji obowiązków, kontach serwisowych, audytowalności, centralnym zarządzaniu, zgodności regulacyjnej i odpowiedzialności administratorów. Tworzymy architektury, modele bezpieczeństwa, standardy i dobre praktyki.

A potem dostajemy do ręki kolejną aplikację SaaS, która nie realizuje połowy tych założeń.

Co więcej, często jest to produkt dużego, rozpoznawalnego dostawcy. Produkt z planem licencyjnym nazwanym Enterprise. Produkt reklamowany jako gotowy dla organizacji, które mają tysiące użytkowników, rygorystyczne wymagania bezpieczeństwa i rozbudowane procesy zarządzania.

Tylko że po wejściu głębiej okazuje się, że Enterprise kończy się tam, gdzie zaczyna się prawdziwe enterprise management.

I nie mówię o niszowych funkcjach, zaawansowanej analityce czy integracjach, bez których można się obejść.

Mówię o fundamentach.

1. Konta serwisowe? Nie, poprosimy imię i nazwisko.

Zacznijmy od czegoś, co powinno być oczywistością.

Nie każdy podmiot korzystający z aplikacji jest człowiekiem.

Organizacje mają konta serwisowe, konta techniczne, tożsamości workloadów, integracje, procesy automatyzacji i systemy, które muszą ze sobą współpracować bez udziału konkretnego pracownika.

To absolutnie podstawowy element nowoczesnej architektury IT.

Tymczasem wciąż trafiam na aplikacje, których model tożsamości zakłada, że każdy użytkownik musi być konkretną osobą. Formularz wymaga imienia i nazwiska. Zaproszenie jest powiązane z osobistym adresem e-mail. Właściciel integracji musi być żywym użytkownikiem, a uprawnienia do zasobów są przypisywane do jego konta.

Można oczywiście wpisać „Automation” w polu imienia i „Service Account” w polu nazwiska. Technicznie problem rozwiązany. Architektura nadal płacze w kącie.

A czasami nawet tego obejścia nie da się zastosować, bo proces rejestracji, weryfikacji, aktywacji lub przypisywania licencji wymaga prawdziwej osoby.

Przykłady konsekwencji?

  • Integracje i automatyzacja: skrypt korzysta z prywatnego tokenu administratora, bo aplikacja nie oferuje tożsamości technicznej ani odpowiedniego modelu uwierzytelniania workloadów.
  • Własność zasobów: konfiguracja, projekt lub integracja należy do pracownika, a jego odejście uruchamia proces ratowania dostępu i przenoszenia własności.
  • CI/CD: pipeline wdrożeniowy wymaga poświadczeń konkretnego użytkownika, zamiast kontrolowanej tożsamości technicznej z ograniczonymi uprawnieniami.
  • Zatwierdzanie operacji: workflow wymaga wskazania konkretnej osoby, mimo że proces powinien być realizowany przez kontrolowaną tożsamość systemową.
  • Audyt: logi pokazują aktywność konta technicznego podszywającego się pod człowieka, co zaciera granicę między działaniem użytkownika a działaniem automatyzacji.

Oczywiście nie każda aplikacja musi oferować identyczny mechanizm. Nie każda potrzebuje klasycznego konta serwisowego. Nowoczesnym rozwiązaniem mogą być aplikacyjne tożsamości workloadów, service principals, OAuth client credentials czy krótkotrwałe poświadczenia federacyjne.

Ale jakiś właściwy mechanizm musi istnieć.

Jeżeli automatyzacja jest wspierana marketingowo, a bezpieczna automatyzacja jest architektonicznie niemożliwa, to mamy problem projektowy, nie problem użytkownika.

2. Centralne zarządzanie? Użytkownik już sobie coś założył.

Drugi problem jest jeszcze poważniejszy.

Użytkownicy potrafią samodzielnie założyć workspace, organizację, tenant, przestrzeń roboczą czy środowisko. W wielu produktach mogą zacząć pracę, zaprosić współpracowników i umieścić dane firmowe w nowo utworzonej przestrzeni, zanim centralne IT w ogóle dowie się o jej istnieniu.

To jest wygodne.

Do czasu, aż próbujesz tym zarządzać.

Niedawno natknęłam się na ten problem w Notion. Użytkownicy założyli własne workspace’y. W organizacji skonfigurowałam SSO i weryfikację domeny, oczekując, że mechanizmy te będą częścią spójnego modelu zarządzania tożsamością i przestrzeniami organizacyjnymi.

Kiedy odkryłam te workspace’y, zwróciłam się do wsparcia z prośbą o wskazanie możliwości ich odnalezienia i uporządkowania.

Odpowiedź sprowadzała się do tego, że nie mogą udostępnić informacji ze względu na swoją politykę.

I tutaj zaczyna się absurd.

Moja organizacja ponosi ryzyko związane z danymi, tożsamościami i dostępem. Ale dostawca nie może pomóc mi zidentyfikować środowisk, które mogą to ryzyko generować, ponieważ jego własna polityka mu na to nie pozwala.

Rozumiem ochronę prywatności. Rozumiem separację klientów. Rozumiem, że administrator jednej organizacji nie powinien otrzymywać swobodnego dostępu do danych innej organizacji.

Ale identyfikacja workspace’u na podstawie zweryfikowanej domeny, wykazanie powiązania z organizacją, bezpieczne przejęcie zarządzania czy uruchomienie kontrolowanego procesu konsolidacji to zupełnie inne kwestie niż dostęp do cudzej zawartości.

Jeśli produkt nie potrafi ich rozróżnić, to jego model zarządzania jest niewystarczający dla przedsiębiorstw.

Co właściwie powinna zapewniać platforma SaaS?

  • Odkrywanie środowisk utworzonych przez użytkowników z domeny organizacji.
  • Centralny katalog workspace’ów, tenantów lub innych jednostek zarządzania.
  • Możliwość kontrolowanego przejęcia zarządzania lub konsolidacji środowisk, z zachowaniem odpowiednich zabezpieczeń.
  • Polityki ograniczające tworzenie nowych, niezarządzanych przestrzeni.
  • Centralne egzekwowanie SSO, MFA i zasad dostępu warunkowego tam, gdzie produkt i jego architektura na to pozwalają.
  • Widoczność zdarzeń, integracji, aplikacji i aktywnych połączeń.
  • Mechanizmy eksportu, retencji, audytu i reagowania na incydenty.

Nie wszystko musi być dostępne w każdej licencji. Ale jeśli dostawca sprzedaje produkt jako rozwiązanie Enterprise, musi umieć odpowiedzieć na pytanie: jak organizacja ma nim zarządzać jako całością?

Samo SSO nie jest odpowiedzią na to pytanie.

SSO kontroluje określony etap uwierzytelniania. Nie jest automatycznie mechanizmem odkrywania workspace’ów, wymuszania przynależności do organizacji, zarządzania danymi ani zapobiegania shadow IT.

Weryfikacja domeny również nie oznacza automatycznie, że wszystkie istniejące środowiska zostaną przypisane do centralnej organizacji.

To są różne mechanizmy. I właśnie dlatego architektura ma znaczenie.

3. Enterprise to nie licencja. To model zarządzania.

Mam wrażenie, że część rynku SaaS pomyliła dwie rzeczy: produkt dostępny dla dużej liczby użytkowników oraz produkt, którym można zarządzać w dużej organizacji.

To nie jest to samo.

Można mieć aplikację, która doskonale obsługuje milion użytkowników, a jednocześnie nie pozwala administratorowi odpowiedzieć na podstawowe pytania:

  • Jakie środowiska istnieją w naszej organizacji?
  • Kto nimi zarządza?
  • Gdzie znajdują się nasze dane?
  • Kto ma dostęp do jakich zasobów?
  • Jakie integracje i tokeny są aktywne?
  • Jakie operacje wykonano?
  • Czy możemy wymusić określoną konfigurację?
  • Czy możemy wykryć i zablokować niezgodne konfiguracje?
  • Czy potrafimy bezpiecznie odebrać dostęp, wyeksportować dane i przeprowadzić offboarding?

To nie są pytania dla administratora, który lubi mieć wszystko pod kontrolą.

To są pytania niezbędne do prowadzenia odpowiedzialnego IT.

W środowiskach regulowanych dochodzą do tego wymagania dotyczące audytowalności, retencji, ochrony danych, zarządzania ryzykiem dostawców, separacji obowiązków oraz wykazywania zgodności.

Jeżeli produkt nie oferuje odpowiednich kontrolek, organizacja nie może po prostu zadeklarować, że będzie zarządzać ryzykiem. Musi mieć techniczną możliwość realizowania tego zarządzania.

Polityka na papierze nie zastąpi brakującej funkcji.

4. Dwa modele IT, których nie da się po prostu skleić

Myślę, że źródła problemu należy szukać również w sposobie, w jaki powstają współczesne aplikacje.

Jeden model zakłada, że użytkownik powinien móc zacząć pracę natychmiast.

Zakłada własną rejestrację, self-service, szybkie tworzenie środowisk, samodzielne zapraszanie współpracowników, integracje dostępne na kliknięcie i jak najmniej przeszkód. To podejście doskonale odpowiada potrzebom małych zespołów, startupów i indywidualnych użytkowników.

Nazwijmy je modelem self-service IT.

Drugi model zaczyna się od innych pytań.

Jak aplikacja zostanie wdrożona? Jak będzie zarządzana? Jakie polityki zostaną zastosowane? Jak będzie monitorowana? Jak wykryjemy niepożądane zachowania? Jak administratorzy będą reagować na incydenty? Jak aplikacja będzie współpracowała z istniejącym modelem tożsamości, systemami SIEM, procesami zarządzania zmianą i wymaganiami compliance?

To model centrally managed enterprise IT.

W tym podejściu użytkownik nadal może mieć wygodny interfejs i dużo samodzielności. Różnica polega na tym, że działa w ramach kontrolowanego środowiska.

Self-service nie musi oznaczać braku governance.

Problem pojawia się wtedy, gdy dostawca projektuje produkt niemal wyłącznie pod pierwszy model, a następnie próbuje sprzedać go klientom oczekującym drugiego.

I wtedy zaczyna się dokładanie kolejnych funkcji: SSO, SCIM, role administratorów, logi audytowe, polityki bezpieczeństwa, integracje z SIEM.

Każda z nich może być wartościowa. Ale jeśli podstawowy model obiektów, tożsamości i uprawnień od początku nie przewidywał centralnego zarządzania, późniejsze rozszerzenia bywają kosztowne, niespójne i pełne wyjątków.

Nie wystarczy dodać administratora do produktu, który nigdy nie został zaprojektowany z myślą o administratorach.

5. Microsoft Teams pokazał, że można dojść do tego z drugiej strony

To nie jest problem nowy.

Pamiętam początki Microsoft Teams, kiedy wizja współpracy w chmurze była znacznie prostsza niż model zarządzania, którego oczekiwały duże organizacje.

Współpraca miała być łatwa, szybka i dostępna. Tworzenie zespołów, zapraszanie ludzi i dzielenie się informacjami miało być naturalne.

Tyle że dla administratora przedsiębiorstwa „łatwo udostępnić” i „bezpiecznie udostępnić zgodnie z polityką organizacji” nie są synonimami.

Z czasem ekosystem Teams i Microsoft 365 rozwijał mechanizmy administracyjne, polityki, kontrolę dostępu, audyt oraz narzędzia governance. Nie wszystkie problemy zniknęły, a zarządzanie tym ekosystemem nadal bywa skomplikowane, ale sam rozwój pokazuje, jak istotna jest ewolucja od prostego narzędzia współpracy do platformy zarządzanej na poziomie przedsiębiorstwa.

Jednocześnie doświadczenie Microsoftu pokazuje, że nie jest to zmiana, którą można przeprowadzić jednym przełącznikiem w panelu administracyjnym.

Jeżeli swoboda użytkownika jest fundamentem produktu, ograniczenia wprowadzane później muszą współistnieć z istniejącymi mechanizmami, zależnościami i przyzwyczajeniami.

To znacznie trudniejsze niż zaprojektowanie właściwych granic od początku.

6. Keeper i paradoks świetnej automatyzacji

Podobny rozdźwięk widzę w produktach, które są świetne pod względem funkcjonalnym, ale problematyczne w obszarze zarządzania uprawnieniami.

Przykładem z mojego doświadczenia jest Keeper.

To password manager z bardzo interesującymi możliwościami automatyzacji i funkcjami przydatnymi dla deweloperów. Jednocześnie jego model uprawnień i przywilejów okazał się dla mnie jednym z najbardziej frustrujących modeli, z jakimi miałam do czynienia.

Problem nie polega na tym, że brakuje jakiejkolwiek kontroli dostępu. Problem polega na tym, że przy próbie odwzorowania rzeczywistych wymagań organizacji można trafiać na kolejne przypadki brzegowe, których nie da się sensownie zaadresować w ramach dostępnych mechanizmów.

A to prowadzi do sytuacji, w której centralne zarządzanie istnieje formalnie, lecz praktyczne odwzorowanie polityki bezpieczeństwa staje się niezwykle trudne.

W bezpieczeństwie nie wystarczy, że produkt ma role, foldery, polityki i administratorów.

Liczy się to, czy da się z nich zbudować spójny, przewidywalny model uprawnień, który działa w rzeczywistych scenariuszach, a nie tylko w dokumentacji.

Jeżeli każda nietypowa sytuacja wymaga kompromisu, wyjątku albo obejścia, to złożoność zarządzania zaczyna zjadać korzyści z wdrożenia.

To również nie jest problem, który można rozwiązać samym dodaniem kolejnej roli.

7. Vibe coding nie jest problemem. Problemem jest architektura, która nie dojrzewa razem z produktem.

Łatwo byłoby obwinić za wszystko vibe coding, startupy i kulturę szybkiego dostarczania oprogramowania.

Nie byłoby to jednak uczciwe.

Szybkie prototypowanie, iteracyjny rozwój i samodzielne wdrażanie narzędzi są wartościowe. Citizen IT może zwiększać produktywność, a self-service potrafi odciążyć centralne zespoły IT.

Problem pojawia się wtedy, gdy początkowy model produktu staje się jego trwałym ograniczeniem.

Aplikacja powstaje z myślą o pojedynczym użytkowniku lub małym zespole. Tożsamość jest tożsamością człowieka. Własność zasobów jest lokalna. Uprawnienia są proste. Konfiguracja należy do użytkownika. Integracje bazują na jego tokenach. Administracja oznacza kilka dodatkowych przycisków.

Produkt zdobywa popularność.

Następnie przychodzi czas na Enterprise.

I nagle okazuje się, że trzeba dobudować hierarchię organizacji, centralne polityki, delegowanie uprawnień, zarządzanie cyklem życia, dziedziczenie ustawień, audyt, odkrywanie środowisk, kontrolę integracji, retencję i cały model operacyjny.

Tymczasem pierwotna architektura nie zawsze jest na to gotowa.

Nie każda aplikacja zbudowana w modelu self-service będzie miała te problemy. Nie każdy produkt korzystający z AI do generowania kodu będzie źle zaprojektowany. Nie każdy startup zignoruje enterprise.

Ale jeśli produkt od początku nie traktuje zarządzania, bezpieczeństwa i zgodności jako elementów architektury, a nie dodatków, ryzyko takiego długu jest ogromne.

I właśnie wtedy zaczyna się kosztowna próba przekształcenia narzędzia dla użytkownika w platformę dla przedsiębiorstwa.

8. Security, Governance, Compliance to nie dodatki premium

Chciałabym, żeby branża zaczęła traktować trzy obszary jako integralną część dojrzałości produktu:

Security. Czy potrafię kontrolować tożsamości, uwierzytelnianie, uprawnienia, integracje i dostęp do danych?

Governance. Czy potrafię zarządzać środowiskami, konfiguracją, cyklem życia, odpowiedzialnością i sposobem korzystania z produktu na poziomie całej organizacji?

Compliance. Czy potrafię wykazać, że wymagane kontrole rzeczywiście działają, a dane i operacje są odpowiednio chronione, monitorowane i audytowalne?

To trzy powiązane, ale odrębne obszary.

Produkt może mieć mocne Security, a słabe Governance. Może zapewniać centralne polityki, ale nie oferować wystarczających dowodów do audytu. Może posiadać rozbudowane logi, ale nie pozwalać ograniczyć niepożądanych konfiguracji.

Nie wystarczy więc sprawdzić listy funkcji.

Trzeba sprawdzić, czy całość pozwala zbudować działający model operacyjny.

I nie, sama etykieta Enterprise ani obecność SSO, SCIM czy RBAC nie stanowią dowodu, że produkt jest gotowy dla przedsiębiorstwa.

To dopiero początek rozmowy.

9. Jak powinien wyglądać prawdziwie dojrzały produkt SaaS?

Nie oczekuję, że każda aplikacja będzie miała tysiąc przełączników i panel administracyjny, który wymaga doktoratu z archeologii interfejsów.

Oczekuję natomiast, że dostawca rozumie, iż organizacja potrzebuje nie tylko korzystać z produktu, ale także zarządzać jego użyciem.

Dojrzała platforma powinna zapewniać co najmniej:

  • Spójny model tożsamości, uwzględniający ludzi, administratorów, integracje i automatyzację.
  • Centralne zarządzanie, pozwalające odkrywać, kontrolować i porządkować środowiska oraz zasoby.
  • Przewidywalny model RBAC, z możliwością delegowania administracji, separacji obowiązków i egzekwowania zasady najmniejszych uprawnień.
  • Kontrolę konfiguracji, w tym możliwość egzekwowania polityk i wykrywania odchyleń.
  • Audytowalność, z odpowiednim zakresem zdarzeń, dostępem do logów i możliwościami ich integracji z systemami monitorowania.
  • Kontrolę cyklu życia, obejmującą onboarding, zmiany uprawnień, offboarding, własność zasobów i odzyskiwanie dostępu.
  • Mechanizmy zarządzania danymi, adekwatne do wymagań organizacji, w tym retencję, eksport, usuwanie i odpowiednie zabezpieczenia.
  • Bezpieczne API i automatyzację, tak aby integracje nie musiały polegać na prywatnych kontach pracowników.
  • Kontrolowane self-service, dzięki któremu użytkownicy mogą pracować samodzielnie w granicach ustalonych przez organizację.
  • Dokumentację rzeczywistych ograniczeń, która pozwala architektowi ocenić produkt przed zakupem, zamiast odkrywać braki po wdrożeniu.

Nie każdy produkt potrzebuje każdej funkcji w identycznej postaci. Wymagania zależą od przeznaczenia, danych i ryzyka.

Ale dostawca powinien wiedzieć, które elementy są potrzebne jego klientom, i umieć wyjaśnić, jak można je zrealizować.

Na koniec

Najbardziej frustrujące jest to, że nie rozmawiamy o problemach, które pojawiły się wczoraj.

To nie są nieprzewidywalne zagrożenia. To nie są egzotyczne wymagania wielkich banków. To podstawowe konsekwencje projektowania oprogramowania dla środowisk, w których istnieją użytkownicy, administratorzy, dane, procesy biznesowe, obowiązki regulacyjne i odpowiedzialność za bezpieczeństwo.

Jeśli dostawca chce, żeby jego aplikacja była używana w przedsiębiorstwach, musi zrozumieć nie tylko to, jak użytkownik ma z niej korzystać, ale także to, jak organizacja ma nad nią panować.

Bo produkt, którego nie można właściwie kontrolować, nie staje się bezpieczny tylko dlatego, że wszyscy korzystają z niego w dobrej wierze.

A licencja Enterprise nie jest certyfikatem dojrzałości architektonicznej.

Jeżeli nie mogę odkryć własnych środowisk, kontrolować tożsamości, zarządzać uprawnieniami, egzekwować polityk i wykazać zgodności, to co właściwie kupuję?

Narzędzie dla użytkownika? Być może.

Platformę Enterprise? To już trzeba udowodnić.

I chciałabym, żebyśmy jako branża zaczęli wymagać tego dowodu znacznie wcześniej, niż w chwili, gdy pierwsze dane firmowe znajdą się w miejscu, nad którym nikt nie ma rzeczywistej kontroli.

LUSI.

Do Not Forward – czy to działa?

Problem

  • W Microsoft Purview, można zdefiniować Sensitivity Label 'Do Not Forward’. Potencjalnie bardzo fajna opcja do zabezpieczenia maila
  • Problem polega na tym, że jeśli w mailu jest plik, to zależnie od tego czy odbiorca ma konto pocztowe 3rd party czy M365 – osoba będzie w stanie plik otworzyć lub nie… i poszkodowana jest osoba posiadająca konto M365!

Wewnętrznie na EXO istnieją dwa workflowy:

  • OTP, dla kont, które nie są RMS-aware (3rd party), klient dostaje link 'pobierz kod’, kod przychodzi na zadeklarowany email i dzięki temu osoba ma dostęp do maila oraz pliku.
  • RMS-aware czyli M365. Microsoft chwali się, że usługa działa cross-tenant… ALE – musi być ALE.

Tutaj link opisujący cross-tenant: Microsoft Entra configuration for content encrypted by Microsoft Purview Information Protection | Microsoft Learn . W praktyce działa to tak (zakładając default configuration), że wiadomość 'Do Not Forward’ faktycznie można odczytać beż żadnych kodów przez posiadacza skrzynki EXO. Ale pliku nie da się otworzyć w żaden sposób… chyba, że zrobimy to tak, jak pisze MS:

”

  • For external users who have a Microsoft Entra account in their own tenant, we recommend you use External Identities cross-tenant access settings to configure trust settings for MFA claims from one, many, or all external Microsoft Entra organizations.
  • For external users not covered by the previous entry, for example, users who don’t have a Microsoft Entra account or you haven’t configured cross-tenant access settings for trust settings, these external users must have a guest account in your tenant.

”

…i cały wspaniały plan łatwego dostarczenia rozwiązania szyfrującego idzie w diabły. Bo kto będzie wszystkim ludziom zakładał konta gości? nie tak miała ta usługa ułatwiać życie – no i co za absurd, że użytkownicy nie-M365 mogą się dostać a M365 nie mogą.

Ale oczywiście nie pisałbym, gdyby nie dało się tego obejść…

Rozwiązanie

Okazuje się, że tym szablonem można zarządzać. Wybiera go Purview, które na ostatnim etapie mail flow, dodaje własne reguły transportowe (niewidoczne) – jeśli email ma jakieś Sensitivity Labels, to usługa dokona odpowiednich modyfikacji, sprawdza typ routingu i wybierze szablon – inny dla EXO, inny dla 3rd party. Tutaj nie da się nic zrobić, ponieważ całość jest black-box.

Ale da się:

  • Stworzyć label o jakiejś nazwie – np. 'Secure Email’, który nic nie robi poza oflagowaniem maila
  • ustawić dwie reguły transportowe na EXO – dla maila z i bez załącznika – dla tej etykiety

W efekcie mamy takie scenariusze dla maila z Do Not Forward (Secure Email):

  • do użytkownika non-M365 z lub bez załącznika: użyj szablonu OTP
  • do użytkownika M365 z załącznikiem: użyj szablonu OTP (inaczej nie ma szansy podejrzeć pliku)
  • do użytkownika M365 bez załącznika: użyj cross-tenant RMS, bo wiadomość się wyświetli

te reguły to:

New-TransportRule `
    -Name "Label secure external mail - Do Not Forward via OME portal" `
    -FromScope "InOrganization" `
    -SentToScope "NotInOrganization" `
    -HeaderContainsMessageHeader "msip_labels" `
    -HeaderContainsWords "MSIP_Label_<LABEL GUID>_Enabled=True" `
    -ApplyRightsProtectionTemplate "Do Not Forward" `
    -ApplyRightsProtectionCustomizationTemplate "OME Configuration"

New-TransportRule `
    -Name "Secure Email external WITHOUT business attachment - DNF native" `
    -FromScope "InOrganization" `
    -SentToScope "NotInOrganization" `
    -HeaderContainsMessageHeader "msip_labels" `
    -HeaderContainsWords "MSIP_Label_<LABEL GUID>_Enabled=True" `
    -ApplyRightsProtectionTemplate "Do Not Forward"

Żeby zdobyć GUID najlepiej użyć get-label, tylko najpierw trzeba się połczyć connect-iPPSSession.

> connect-iPPSSession -UserPrincipalName nexor@w-files.pl
> get-label|select name,guid
[...]

A jeśli ktoś byłby chętny modyfikować szablon [OTP/native, disclaimers, images…] to jest to szablon 'OME Configuration’:

> get-oMEConfiguration|fl

TemplateName : OME Configuration
Image :
ImageUrl :
EmailText :
PortalText :
DisclaimerText :
BackgroundColor :
IntroductionText :
ReadButtonText :
OTPEnabled : True
SocialIdSignIn : True
ExternalMailExpiryInterval : 00:00:00
PrivacyStatementUrl :
Identity : OME Configuration
IsValid : True
ObjectState : Unchanged

I ten właśnie default jest użyty w pierwszej regule, z parametrem 'OTPEnabled: True’.

Rebranding a nazwa usługi

To jedna z tych usług w stajni Microsoft, która po pierwsze od zawsze jest zaniedbana, i jak gorący kartofel – przechodzi rebranding co kilka lat. A podstawowe funkcjonalności – jak widać w tym scenariuszu – są często zaparkowane na zawsze. Po raz pierwszy wdrażałem RMS na Server 2oo8 – właśnie mniej-więcej w roku wydania serwera. Niemal dwie dekady, a usługa cały czas boryka się z tym samym problemem – fajnie działa w obiegu firmowym, zamkniętym, gorzej z zastosowaniem powszechnym, tzw. publicznym Internecie. A co najciekawsze to zasadniczo wszystko działa i wszystkie elementy układanki są dostępne… tylko MS z jakiegoś powodu wymyślił 'zakładajcie wszystkim konta gości’ zamiast pójść po rozum i zmienić workflow /:

Co do historii nazw:

Rok Nazwa
2003 Windows Rights Management Services (RMS)
2008 Active Directory Rights Management Services (AD RMS)
~2013 Azure Rights Management (Azure RMS)
~2015-2019 Azure Information Protection (AIP)
~2019-2021 Microsoft Information Protection (MIP)
obecnie Microsoft Purview Information Protection (MPIP)

I na wszystkie te nazwy można cały czas natrafić podczas korzystania z produktu – np. do otwarcia zaszyfrowanego pliku należy zainstalować RMS Client – pewnie ze względu na to, iż tak cały czas nazywa się w środowisku on-premises, na Server 2o25. W chmurze natomiast czas nie stoi – dla tego dziś mówimy o Purview i Sensitivity Labels…

A więc zasadniczo, na dzień dzisiejszy: MPIP – Microsoft Purview Information Protection, korzystający z RMS do szyfrowania plików.

AI nie pomogło

Takie problemy to dobry benchmark AI – tutaj nie pomogło. Nie znalazłem rozwiązania wyszukiwarką, a AI, jak się okazało, nie było w stanie samodzielnie 'rozumować’ – skoro nie znalazło tekstu, to 'nie wymyśliło’ rozwiązania. Udało mi się przygotować to rozwiązanie tylko dla tego, że pracując tyle z Ex/EXO po prostu wiedziałem czego szukać i po kilku próbach udało się wydziargać rozwiązanie…

eN.


LockedShields 2o25

w tym roku po raz kolejny stanęliśmy na podium LockedShields, organizowanego przez CCDCOE. POL-FRA drużyna stanęła na wysokości zadania, minimalnie ustępując drużynie z Niemiec.

to ważne wydarzenie dla mnie co roku – zupełnie inne spojrzenie na bezpieczeństwo i pracę w stanie wysokiego stresu. przez 3 dni miałem dostarczane jedzenie na biurko, a wypad na siku raportowany resztom osób, bo przez 2 min nie jestem w stanie wspierać reszty teamu. świetny trening, który przypomina mi, jak bardzo różni się dzień powszedni od sytuacji kryzysowej. trzeba wykrzesać z siebie więcej, pracować inaczej, a 'książkowe zasady’, które stosuje się na co dzień do zabezpieczania systemów nagle stają się farsą i trzeba rzeczy adresować zupełnie inaczej.

pomimo wysokiej lokaty ten rok wyjątkowo oberwaliśmy [jako team AD] – szacun dla Red Teamu, tym razem nas wyprzedzili. ale to dobrze – chodzi o to, żeby się rozwijać, nie spocząć na laurach i co rok odtwarzać te same procedury. co z takich ćwiczeń się wynosi to tzw 'drill’:

  • praca w nietypowych warunkach wymagająca podejmowania natychmiastowych decyzji
  • hierarchia i wykonywanie rozkazów – wbrew pozorom, bardzo trudne dla cywilnych IT. mamy swoją dumę, wielu z nas w wojsku nie było i przyzwyczajeni do brylowania w środowiskach, w których pracujemy, wcale nie jest łatwo utrzymać hierarchię, słuchać rozkazów. starcie charakterów, umiejętność 'zamknięcia się’ i po prostu zrobienia czegoś, nawet jak się z tym nie zgadzamy czy przekazane jest zbyt dosadnie… komunikacja i zarządzanie kryzysowe 'w praktyce’ to co innego niż narysowanie drzewka na papierze.
  • przestrzeganie procedur ale i umiejętność improwizacji, kiedy zawodzą

do tego oczywiście duża dawka wiedzy od reszty zespołów, co też ma swoje znaczenie, jednak IMHO 'drill’ w takich sytuacjach jest najcenniejszym doświadczeniem.

wiele food for though na przyszły rok po otrzymaniu wyników – mam szczerą nadzieję, iż będę miał zaszczyt i okazję poprawić ochronę naszej części środowiska i udowodnić, że się rozwijamy – technicznie i i w zakresie zarządzania kryzysowego.

dziękuję gorąco całemu zespołowi LS25 i wielkie kudos dla organizatorów, bo impreza jest na na prawdę wysokim poziomie!

PS. dla wszystkich, którzy chcieliby wesprzeć kraj jako cywile – Dowództwo Komponentu Wojsk Obrony Cyberprzestrzeni uruchomiło program CyberLEGION.

eN.

Authentication Methods – wymuszenie telefonu dla ról uprzywilejowanych (MSP)

Authentication Methods pozwalają w granularny sposób skonfigurować, które metody uwierzytelnienia działają, a które nie. Dobrze jest, zgodnie z zaleceniami, wyłączyć uwierzytelnienie przez telefon – zarówno połączenie głosowe jak SMS, ponieważ te metody są stosunkowo łatwe do złamania

Najlepiej więc te metody wyłączyć. Przy okazji przypomnę, że warto zmigrować do nowego modelu MFA, z procesu którego pochodzi poniższy obrazek:

Tutaj pojawia się ciekawostka, której nie znalazłem w żadnym artykule:

  • Konta należące do rol uprzywilejowanych mają te metody włączone bez względu na ustawienia

Czyli nawet jeśli wykona się wszystkie kroki – pełną migracją do nowego modelu, wyłączy SMS i voice, konto należące np. do roli Global Administrator czy choćby User Administrator, nadal będą mieli ekrany zmuszające do ustawienia telefonu… jest opcja 'choose another method’ – i tutaj też lekkie zaskoczenie – dostępny jest hardware token, phone oraz email.

A więc te najważniejsze konta mają zakodowane najmniej bezpieczne metody. Oczywiście – jeśli jest to konto:

  • dla konkretnego administratora, w konkretnej firmie
  • break glass account

fizyczny klucz FIDO2 rozwiązuje temat. powinien wręcz być podstawową sugestią wizarda konfiguracji konta.

problem pojawia się w środowisku gdzie pojedyncze konto używane jest przez wielu operatorów – myślę głównie o środowiskach MSP… „HEREZJA!” chciałoby się krzyknąć. sytuacja niedopuszczalna – żeby jedno konto było współdzielone przez kilku użytkowników. zasadniczo tak właśnie jest – nie powinno się współdzielić kont, ponieważ łamie to podstawowe zasady bezpieczeństwa, choćby 'Accounting’ z AAA principle, nie pozwalając na jednoznaczną identyfikację 'kto wykonał operację’. są inne, prawidłowe metody zarządzania:

  • indywidualne konta i PIM. perfekcyjne dla dużych firm ale dla małych koszty EID P2 są duże, a w przypadku MSP posiadanie wielu kont dla całej obsługi, w każdym zarządzanym tenancie jest nierealne
  • GDAP dla MSP. świetna idea, ale niestety Microsoft nigdy nie potrafił wdrożyć jest dobrze. portal partnerski był kupą i nią pozostał nawet po pełnym liftingu. jak ktoś raz na miesiąc potrzebuje coś sprawdzić to pewnie zbierze się na cierpliwość żeby skorzystać z tego narzędzia, ale do codziennej administracji potrzeba byłoby zatrudniać mistrzów ZEN. poza prędkością działania, to się po prostu sypie i nie wszystkie operacje są obsługiwane, część po prostu wymaga bezpośrednio zalogowania się jako GA.
  • różne aplikacje firm 3-cich, które mają pełny dostęp i własny model bezpieczeństwa. wprowadzają dodatkową warstwę abstrakcji, dając możliwość uwierzytelnienia z centralnego, zintegrowanego tenanta MSP czyli zapewniają audyt zmian, pod spodem działając przez GraphAPI. brzmi nieźle – i to kolejne fajne rozwiązanie dla większych, ale ze względu na koszty (głównie związane z utrzymaniem i wprowadzaniem dodatkowej złożoności) – znów sprawia problemy mniejszym firmom.
  • można też oczywiście przygotować wiele kluczy FIDO2 tak, żeby każdy miał swój. to chyba w miarę najprostsza metoda. choć niezbyt tania, to jest to jednorazowy koszt w przeciwieństwie do comiesięcznych subskrypcji i utrzymania…

Microsoft zawsze przede wszystkim patrzył na Enterprise, pozostawiając mniejszych trochę na pastwę nieprawidłowych praktyk. to w sumie niuans, ale w czasach, w których codziennie padają kolejne firmy i co chwilę pada kolejny rekord w kwestii tego ile danych udało się wydobyć czy co złamać, takie niuanse nie pozostają bez znaczenia.

eN.

Locked Shield 2o24

Po raz trzeci miałem zaszczyt uczestniczyć w największych ćwiczeniach (zawodach?) niebezpieczeństwa, organizowanych przez CCDCOE (NATO Cooperative Cyber Defence Centre of Excellence) i po raz kolejny skończyliśmy na podium. przez zamieszanie z punktami ciężko powiedzieć czy na 1 czy na 2 miejscu ale jedno jest pewne – co roku Polska drużyna jest wśród najlepszych!

od zeszłego roku dodatkowym celem ćwiczenia jest wymiana wiedzy i nauka koordynacji zadań między krajami, występuje się w parach – w tym roku walczyliśmy ramię-w-ramię z Finami.

i choć ćwiczenia odbywały się w strefie czasowej CET, co oznaczało dla mnie przestawienie dnia i olbrzymi wysiłek – nie żałuję. to świetne doświadczenie i jestem dumny z naszego wyniku. „dywizja AD” (; trzymała się świetnie przez cały czas pozostając all-green w zasadzie od początku do końca. trochę nas postraszyli w ostatniej fazie, ale daliśmy radę i to rozwiązać szybko i sprawnie.

szczególne podziękowania dla naszego leadera – Grześka i pozostałych członków teamu AD – Roberta, Tomka i Marka.

eN.

LockedShields 2o23

LockedShields 2o23

jako fan społeczności i pracy organicznej, cieszą mnie inicjatywy, w których duże organizacje – rządowe, czy militarne – starają się budować i wspierać społeczności, rozumiejąc jak ważną rolę pełnią. zwłaszcza w czasach niepokoju, a takie teraz mamy, super-istotne jest, żeby ludzie umieli się organizować w warunkach rozproszenia, pod silną presją, bez centralnego dowodzenia, samodzielnie decydując i działając. żeby umieli się wspierać i podejmować akcje.

tym właśnie jest ćwiczenie LockedShields, organizowane przez CCDCOE a w Polsce przez Wojska Obrony Cyberprzestrzeni. po raz drugi miałem zaszczyt wziąć udział w tym wydarzeniu, jako członek Blue Team i wspólnie wywalczyliśmy 3cie miejsce. biorąc pod uwagę, iż udział bierze 38 krajów z krajów NATO, konqrencja jest na prawdę zaciekła i decydują szczegóły – więc choć chciałoby się więcej, trzecie miejsce jest świetnym wynikiem i jestem szczerze dumny, że mogłem się do niego przyczynić.

dużo nauki, świetna ekipa, niesamowici specjaliści i atmosfera współpracy – wszystko to, co powoduje, że chce się być częścią tej społeczności (: nie sposób podziękować całemu zespołowi, ale szczególne kudosy dla pozostałych obrońców Active Directory w tym roq: Robert Przybylski,  Tomasz Rupiewicz i Marek Żach. chociaż daliśmy radę chronić usługę świetnie, i zajęliśmy #1 [jako cały Blue Team] w dostępności usług, jak zwykle dużo do analizy po ćwiczeniu, tzw. lesson-learned.

oficjalnie od Wojska Polskiego.

samotny wilk, eN.


Passwordless dla Microsoft Account

niedawno Microsoft ogłosił funkcję 'passwordless’ dla kont 'Microsoft Account’ – czyli tych nie-firmowych/nie-szkolnych. wszystkie arty dot. braq haseł rozpływają się w zaletach tego rozwiązania i ah, oh [fapfap] … więc daruję sobie powtarzanie zalet braq hasła. funkcję włączyłem i … obniżyłem sobie bezpieczeństwo dostępu.

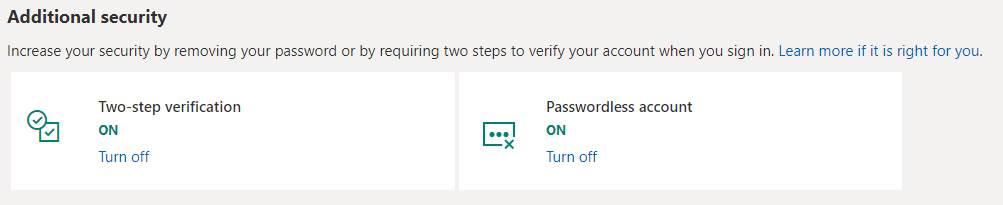
trzeba jasno odgrodzić passwordless dla firm i funkcje Windows Hello for Business, który zakłada MultiFactor Auth – z naciskiem na ’Mutli’, od passwordless dla kont MS. zastanawiałem się jak to będzie praktycznie zrealizowane, włączyłem –  i osobiście mnie to trochę przeraża – ponieważ z MFA wracamy do Single Factor Auth, którym jest nasz smartfon. nie spodziewam się, aby wiele osób miało na kontach dane warte ucięcia komuś kciuka [i przechowywania w odpowiednich warunkach], ale mimo wszystko logowanie, w którym JEDYNYM czynnikiem jest kliknięcie na ekranie telefonu, budzi u mnie alarm. jakiś czas temu, o ile pamiętam, była opcja dodatkowego zabezpieczenia apki Microsoft Authenticator PINem. dziś znajduję w opcjach jedynie 'require biometric or PIN’ ale bez możliwości wyboru – wygląda na to, że ustawienie pobierane jest z systemu (sprawdzałem na Android) – a więc czy będzie to odcisk, czy PIN – będzie to TEN SAM odcisk/PIN, co do reszty. ciekawy jestem czy ta formuła faktycznie zadziała – dowodem będzie, że przez najbliższe kilka lat będzie funkcjonować w tej postaci, będzie używana, a w prasie nie zaczną się pojawiać arty o tym jak to wypłynęła porcja danych/zdjęć/doqmentów bo ktoś zgubił smartfona. imho bardzo szybko pojawi się nowa wersja apki lub ustawienie, które doda jakiś drugi czynnik – może PIN, może kod SMS, czy choćby wybór obrazka. co ciekawe w ustawieniach konta nadal widzę 'Two-step auth ON’ – pomimo, że loguję się teraz tylko przykładając palec do ekranu.

niezależnie od mojej subiektywnej opinii, każdy powinien zrewidować swoje ustawienia haseł i upewnić się:

  • czy na pewno mamy skonfigurowane dodatkowe metody uwierzytelnienia?
  • czy je pamiętamy? [np. czy znamy odpowiedzi do pytań weryfikacyjnych]
  • czy ustawienia tych metod nie zapętlają się?

jeśli naszą drugą metodą jest adres email, który ma włączone MFA oparte o tą samą apkę – to tracąc telefon nie zalogujemy się nigdzie. powinniśmy mieć realną alternatywę inaczej czeka nas długie przebijanie się przez support. jeśli coś takiego wydarzy się gdy nie mamy czasu, będziemy w kropce. każdy powinien poświęcić czas chociaż raz, i 'na niby’ zgubić telefon. wyłączyć go i sprawdzić gdzie jest w stanie się zalogować, czego braqje, ile to trwa czasu. w firmach na podobne scenariusze powinny istnieć procedury, ale sprawę ułatwia, że zazwyczaj jest kilq administratorów, więc w większości scenariuszy są sobie w stanie pomóc na wzajem. prywatnie, nas czeka przebijanie się przez linie wsparcia – warto przynajmniej spróbować, żeby oszacować ile to może trwać czasu i jak w ogóle taka procedura wygląda.

z jednej strony firmy dwoją się i troją, żeby było bezpieczniej a zarazem łatwiej… wygoda na pewno się zwiększa – ale w momencie kiedy coś się sypnie, zaczynają się schody. i wcale nie jest łatwo wymyśleć i skonfigurować swoje konta tak, aby faktycznie odzyskać awaryjnie dostęp szybko i bezpiecznie.

ciekaw jestem opinii – bo na razie nie trafiłem na te negatywne czy krytyczne. moja jest dość mieszana – niby wygodnie, ale [w przypadku kont prywatnych] na pewno nie bezpieczniej!

eN.


bezpieczne hardcodowanie hasła w skrypcie

bezpieczne hardocodowanie hasła?

uruchamiając skrypt, najbezpieczniej jest NIE hardcodować hasła. jeśli coś jest w skrypcie, to znaczy, że może być wykorzystane w nieautoryzowany sposób. jednak przykłady z życia pokazują, że czasem taka jest konieczność .. czy po prostu zlecenie (; przykład – obsługa wsparcia, która ma korzystać ze skryptu, który gdzieś tam sobie sięga. to 'gdzieś tam’ to środowisko, w którym nawet owa obsługa nie ma konta.

podstawowe zasady bezpieczeństwa to 3xA (AAA) – Authentication, Authorization & Accounting. jeśli utworzymy konto serwisowe, które ma coś wykonywać w imieniu uruchamiającego, to aby nie złamać zasady AAA i być w stanie stwierdzić kto wykonał daną akcję, trzeba to przesunąć do miejsca, gdzie uruchamia się skrypt/aplikację i umieć to powiązać… dalej mogłoby być o SIEM i tak dalej… ale nie o tym tutaj. ogólnie najważniejsze – wykorzystanie konta serwisowego (w środowisq legacy-domain), czy aplikacji proxy (tak jak działa to w Azure) nie musi koniecznie być złem, ale pozostaje pytanie… *jak zamieścić hasło skrypcie tak, aby nie wyciekło wraz ze skryptem?*

najbezpieczniej byłoby wykorzystać certyfikat… tak to można zrobić np. dla aplikacji Azure. niestety w środowisq klasycznym, gdzie mamy np. wykonać akcję w domenie, nie jest to łatwe. najbezpieczniej byłoby umieszczenie serwisu aka proxy, który działa sobie na serwerze w owej domenie i do tegoż serwisu uwierzytelniać się certyfikatem. spoko ale to developerka i do 'małych projekcików’ czy 'drobnych narzędzi’ – po prostu jest za duża czasochłonność (czyt. koszt), nie wspominając o tym że napisanie własnego serwisu (np. wystawiającego REST API) to nie jest już skryptowanie. to developerka.

no więc zróbmy to, co da się zrobić tak, aby było szybko i *możliwie* bezpiecznie.

…na ile się da

skoro nie jesteśmy w stanie uwierzytelnić się certyfikatem, to przynajmniej zaszyfrujmy hasło certyfikatem. co nam to da:

  • dany skrypt będzie działał wyłącznie na tej maszynie gdzie jest certyfikat i dla tych osób, którym na to pozwolimy.

żeby była jasność – jeśli ktoś, kto ma złe intencje będzie tego skryptu używał, to sobie hasło odkoduje. ale po pierwsze – 'pierwszy lepszy’ tego nie zrobi, po drugie – jeśli założylibyśmy takiej osobie konto, to i tak wykorzysta je do niecnych celów. trzeba wiedzieć że to może być rozwiązanie *good enough* i tylko w tym kontekście można nazwać je 'bezpiecznym’. spory disclaimer ale nie chcę przypadkowych czytelników wprowadzić w błąd.

jak już wyjaśniłem co rozumiem przez 'bezpieczne’, recepta:

  1. załóż konto w domenie, bez żadnych dodatkowych uprawnień
  2. dobrze byłoby poustawiać 'deny’ dla takiego konta, przykrajając odpowiednio uprawnienia – wedle potrzeby, uznania i paranoia-level
  3. nadać uprawnienia do tego, do czego będzie wykorzystywane
  4. wygenerować odpowiedni certyfikat, zainstalować go i odpowiednio nadać uprawnienia
  5. zaszyfrować hasło certyfikatem
  6. i voila.. można go wykorzystać w skrypcie

punkty 1-3 pominę, natomiast 4-6 zaraz opiszę.

dzięki takiej konfiguracji – skrypt, nawet skopiowany czy przypadkowo udostępniony, na niewiele się zda. aby wydobyć hasło – trzeba mieć dostęp do klucza prywatnego certyfikatu.

generowanie certyfikatu

super proste, przy czym do tego celu cert musi spełniać odpowiednie funkcje, czyli (nomen-omen) kluczem jest dobry key-usage i document type:

$cert=New-SelfSignedCertificate -DnsName "script automation" -CertStoreLocation "Cert:\CurrentUser\My" -KeyUsage KeyEncipherment,DataEncipherment,KeyAgreement -Type DocumentEncryptionCert

$cert|Export-PfxCertificate -FilePath C:\temp\scriptautomation.pfx -Password (ConvertTo-SecureString -String "secret-string" -Force -AsPlainText)

dodatkowo można certyfikat usunąć z własnego komputera tak, aby jedna kopia była w pliq:

$cert|remove-Item

…albo zachować go jako backup a usunąć potem plik. up2u.

instalacja w środowisq docelowym

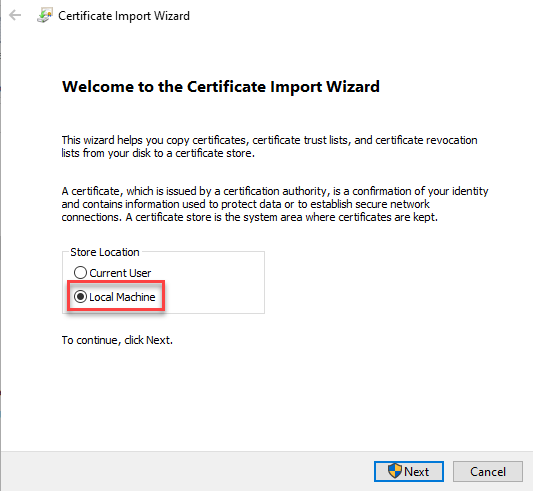
najłatwiej oczywiście kliknąć sobie na pliq pfx i wybrać opcję 'local machine’. jeśli umieścimy w 'current user’ to będzie dostępny tylko dla nas.

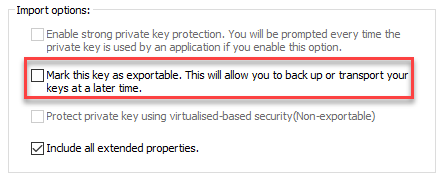
kolejną hiper-istotną kwestią jest *NIE włączanie* możliwości exportu klucza.

jeśli ktoś woli z PowerShell – należy użyć ’import-pfxCertificate’ *bez* parametru -exportable.

Import-PfxCertificate -FilePath C:\temp\scriptautomation.pfx -Password (ConvertTo-SecureString -string "secret-string" -force -AsPlainText) -CertStoreLocation Cert:\LocalMachine\My\

ciekawostka: w PS 5.1 ten commandlet ma dodatkowy parametr, nieopisany w doc, protectPrivateKey, który pozwala wykorzystać Virtual Secure Mode.

to połowa sukcesu – bo do tak zaimportowanego certyfikatu, nikt bez uprawnień administratora nie będzie mógł skorzystać. należy nadać uprawnienia do klucza prywatnego:

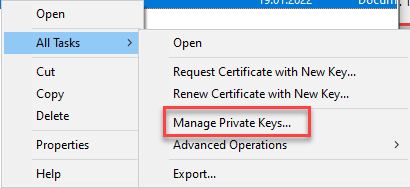
  1. odpal 'certlm.msc’ (zarządzanie certyfikatami komputera)
  2. wybierz certyfikat i kliknij PGM
  3. jest tam opcja 'manage private keys…’

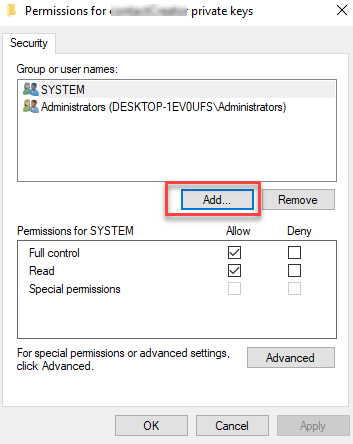
4. nadaj uprawnienie READ (nie FC!) dla wybranych osób

kodowanie i odkodowanie hasła

teraz już z górki. przygotowanie środowiska to bardziej wymagający element, ponieważ hasło można zaszyfrować za pomocą polecenia ’protect-cmsMessage’:

C:\_scriptz :))o- Protect-CmsMessage -To 'cn=script automation' -Content 'moje tajne hasło'
-----BEGIN CMS-----
MIIBtAYJKoZIhvcNAQcDoIIBpTCCAaECAQAxggFMMIIBSAIBADAwMBwxGjAYBgNVBAMMEXNjcmlw
dCBhdXRvbWF0aW9uAhB2BdZafxn2nkcWjQNvBi+pMA0GCSqGSIb3DQEBBzAABIIBAFY0TU8LAPl4
4IAWp9tGDOZK/bAEwQpZPix5dz8AoOpaDckpZ8dqatggEKq7vo4VX6wL4sBkImQoZrCZjkT7oCSi
N1YFDOIghjD7e2mIvEl/Gq2bReUbsFQ0iw6Wg1K8zVLBzDQAIUHgJvaV2Ssf4nCJ8WfW5d9UzmBB
JpHAmy7cdofboQt6hRz0wafGNivD47z2xNSSVyhqHVUzBt6NWmAYouFMGYGsBZBuOHXnQJzh+saG
Q5VpWxZGRHzM3igl8IgYDF75R+b/FSfciPu5Se2eeD6xxHrPj9rfLm37KVIab/4+QA/lRFVt4cwA
ztjhh8puyPqYgKCE7t0Tp5VNQv4wTAYJKoZIhvcNAQcBMB0GCWCGSAFlAwQBKgQQjmYztOm64boC
6XqnH/9kMYAgYTQlOXeGex7qMH5S5gVRKy/JOhfIdqlabP9e/N/6iRk=
-----END CMS-----

ciekawostka: przy tym mechaniźmie szyfrowania (Cryptographic Message Syntax), uruchomienie tego polecenia, da za każdym razem inny wynik

jeśli ktoś nie pamięta nazwy certu, to można je szybko wylistować:

C:\_scriptz :))o- ls Cert:\LocalMachine\My\

PSParentPath: Microsoft.PowerShell.Security\Certificate::LocalMachine\My

Thumbprint Subject
---------- -------
B643393E34BDC10BE2266F307F63A712578416F1 CN=script automation

wkleić sobie ten ciąg do skryptu i kiedy potrzebne jest hasło, użyć unprotect-CMSMessage… np. tak:

[string]$encPass="-----BEGIN CMS----- 
MIIBtAYJKoZIhvcNAQcDoIIBpTCCAaECAQAxggFMMIIBSAIBADAwMBwxGjAYBgNVBAMMEXNjcmlw
dCBhdXRvbWF0aW9uAhB2BdZafxn2nkcWjQNvBi+pMA0GCSqGSIb3DQEBBzAABIIBAFY0TU8LAPl4
4IAWp9tGDOZK/bAEwQpZPix5dz8AoOpaDckpZ8dqatggEKq7vo4VX6wL4sBkImQoZrCZjkT7oCSi
N1YFDOIghjD7e2mIvEl/Gq2bReUbsFQ0iw6Wg1K8zVLBzDQAIUHgJvaV2Ssf4nCJ8WfW5d9UzmBB
JpHAmy7cdofboQt6hRz0wafGNivD47z2xNSSVyhqHVUzBt6NWmAYouFMGYGsBZBuOHXnQJzh+saG
Q5VpWxZGRHzM3igl8IgYDF75R+b/FSfciPu5Se2eeD6xxHrPj9rfLm37KVIab/4+QA/lRFVt4cwA
ztjhh8puyPqYgKCE7t0Tp5VNQv4wTAYJKoZIhvcNAQcBMB0GCWCGSAFlAwQBKgQQjmYztOm64boC
6XqnH/9kMYAgYTQlOXeGex7qMH5S5gVRKy/JOhfIdqlabP9e/N/6iRk=
-----END CMS-----"

try {
  $cert = Get-ChildItem Cert:\LocalMachine\My\B643393E34BDC10BE2266F307F63A712578416F1 -ErrorAction stop
} catch {
  write-log "missing authentication certificate. quitting" -type error
  retrun $null
}
  if(-not $cert.HasPrivateKey) {
  write-log "missing decription factor. quitting." -type error
  return $null
}
  $certCN = $cert.Subject
try {
  [securestring]$secStringPassword = ConvertTo-SecureString (Unprotect-CmsMessage -Content $encPass -To $certCN -ErrorAction stop) -AsPlainText -Force
} catch {
  write-log "error decrypting auth password $($_.exception)" -type error
  return $null
}
[pscredential]$creds = New-Object System.Management.Automation.PSCredential ('CORP\SVC-contactCreator', $secStringPassword)

inne scenariusze i metody

jakiś czas temu linkowałem dostęp do EXO certyfikatem. wygodne.

a podczas uruchamiania własnych skryptów, i tam gdzie wystarczą zwykłe credsy, nie chce mi się wpisywać hasła. zapisuję więc je sobie do pliq:

if(test-path $credsFile) {
    $myCreds = Import-CliXml -Path $credsFile
    write-log "used saved credentials in $credsFile" -type info
} else {
    $myCreds=Get-Credential
    if($NULL -eq $myCreds) {
        write-log 'Cancelled.' -type error
        exit -3
    }
    if($saveCredentials) {
        $myCreds | Export-Clixml -Path $credsFile
        write-log "credentials saved as $credsFile" -type info
    }
}

get-Credential używa DPAPI i w 'zamkniętym’ środowisq (np. na własnym lapq) w zupełności wystarcza. z tego co kojarzę szyfrowane jest kluczem użytkownika i komputera więc taki plik, aby był odczytany, musi być w tym samym środowisq. mimo wszystko w 'otwartym’ środowisq raczej nie należy stosować takich metod.

eN.


wygaszanie tokenów – zmora bezpieczeństwa i CAEP

Obsługa tokenu w czasie rzeczywistym

wpis dotyczy nowego mechanizmu bezpieczeństwa – Continues Access Evaluation Protocol. bardzo fajnie, że Microsoft w końcu adresuje bardziej życiowe sytuacje dotyczące sesji użytkownika – konkretnie obsługę wymuszenia wygaśnięcia tokenu uwierzytelnienia. obserwując jednak z poziomu wyższego, działania aplikacji, mam obawy, że to nie adresuje najważniejszych bolączek. przekonamy się wkrótce.

ale…. o czym ja mówię?

przykład podany w linkowanym arcie dotyczy wymuszenia wygaśnięcia tokenu bezpieczeństwa np. w przypadq zmiany typu sieci (biurowa/otwarta) w trakcie trwania sesji. w tej chwili token jest przyznawany na 1h i sobie jest póki nie wygaśnie.

ale obserwuję większy problem. 1h nie brzmi jak problem – ale już 2 dni? z praktyki i obserwacji tak właśnie to wygląda – użytkownicy, którzy zostali zablokowani lub wyłączeni często mają dostęp do danych nawet przez kilka dni. na to ile de facto to będzie czasu, wpływa wiele czynników:

  • czy środowisko jest cloud-only czy hybryda
  • jeśli hybryda to w jakim trybie – PHS, PTA czy ADFS? każdy z mechanizmów zmienia przebieg procesu uwierzytelniania i znacząco zmienia wiele aspektów związanych z bezpieczeństwem tożsamości.
  • pośrednio konfiguracja Conditional Access
  • wykorzystanie Cloud App Security – który podobnie do CAEP ma na celu kontrolę sesji a nie warunków dostępu
  • system operacyjny na końcówce – iOS, Android, Windows… na każdym apki zachowują się nieco inaczej
  • inne ustawienia typu konfiguracja serwera MFA w AAD ile czasu może być cache’owany.

w efekcie miałem okazję obserwować sytuacje, w których użytkownik jeszcze przez kilka dni (sic!) miał dostęp do swojego maila. tak – mógł odbierać i wiadomości. póty, póki nie zabił aplikacji na urządzeniu – dopiero wtedy pojawiło się żądanie uwierzytelnienia.

jest nadzieja, że ta oddolna zmiana opisuje tylko część konsekwencji ale w rezultacie zaadresuje ten problem – zwłaszcza, że pierwszymi klientami, które dostaną update jest Outlook i Teams.

procedury w przypadkach krytycznych

jest (teoretyczna) możliwość zabicia wszystkich sesji użytkownika i zmuszenia go do odświeżenia tokenu. jest również możliwość wyczyszczenia danych na końcówkach.

wipe-out

wyczyszczenie danych na końcówce jest możliwe jedynie jeśli zarządzane są aplikacje lub stacja – scenariusze BYOD z managed apps oraz klasyczny MDM z tzw. 'enrollmentem’ urządzeń. odpowiednik 'dodania do domeny’ pod kontrolę InTune (lub innego MDM) do zarządzania końcówką. wtedy zależnie od scenariusza (managed apps/MDM) możemy z portalu Azure wymusić wyczyszczenie danych firmowych (managed apps) lub całego urządzenia (MDM).

warunkiem jest oczywiście, że urządzenie zarejestruje się do sieci, co w przypadq świadomej kradzieży w celu pozyskania danych nie jest oczywiście dużym pocieszeniem. warto również pamiętać, że to już podlega licencjom InTune.

reset sesji

ciekawszym i bardziej powszechnym scenariuszem jest reset sesji użytkownika. po co? uwierzytelnienie jest 'bramą’ którą jak się przekroczy, mamy określony czas przebywania (sesję). do tego należy dodać różne mechanizmy cache – obecne zwłaszcza w aplikacjach mobilnych, ze względu na … mobilność. czyli częste utraty sieci i zmiany punktów dostępowych. pomimo, że token uwierzytelniania żyje 1h, to sesja utrzymywana jest, aż do zerwania albo jakiegoś timeoutu w aplikacji. dla Outlook obserwowałem długie czasy, sięgające nawet 2 dni [dodam, że taki scenariusz miałem ok roq temu – to o tyle istotne, że przy obecnej szybkości zmian, nie do końca wiadomo co jest aktualne. nie robiłem testów ostatnio].

(teoretyczny) reset sesji można wykonać na 3 sposoby. czy też może w 3ech krokach? bo nie jest dla mnie oczywiste w których częściach te kroki się pokrywają a w których wymagają wykonania oddzielnie [zapraszam do komentarzy i wrzucenia linqw – jeśli ktoś posiada materiały wyjaśniające te 'detale’, a jakże istotne ze względu na bezpieczeństwo].

  • z interfejsu AAD, w części 'Authentication Methods’ – opcja 'Revoke MFA sessions’
  • z PowerShell Revoke-AzureADUserAllRefreshToken, który zgodnie z opisem 'unieważnia wszystkie tokeny wydane dla aplikacji użytkownika’
  • z portalu M365 Admin Center – wyszukując użytkownika, w zakładce… OneDrive. tam dostępna jest opcja, która obecnie opisana jest 'Sign-out of all Office 365 sessions’

historycznie opcja 'sign-out user sessions’ działała tylko dla OD właśnie. czy dziś, zostając w tym samym miejscu w interfejsie, zrywa faktycznie sesje? podam taki przykład świeży, z przed miesiąca:

wraz z końcem miesiąca, zakończyło pracę sporo osób pracujących w projekcie i z dostępami administracyjnymi. ok. 3 dni później zgłasza się do mnie jedna z osób z pytaniem, czemu osoba, która już nie powinna być w organizacji 'świeci się w Teams na zielono’ – czyli jest jako aktywna. konto zablokowane, wszelkie resety porobione. nie pomaga. mija kolejny dzień – nadal 'active’. zakładam ticket w MS Support, jakaś tam analiza logów, że user zablokowany, że na pewno nie może się dostać – generalnie nic, czego bym nie wiedział. odpowiedzi na to, czemu sesja jest widoczna jako 'active’ i jak taką sesję zabić – brak. w tej sytuacji nie było zagrożenia, bo faktycznie wszystko było poblokowane i potwierdzały to logi dostępowe, ale ogólnie… brak narzędzi pozwalających na jakąkolwiek kontrolę sesji użytkowników to spory problem chmury. pozostawia sporo niejasności, co w kontekście bezpieczeństwa nie jest pożądane.

liczę na to, że implementacja CAEP znacząco poprawi element kontroli sesji….

eN.

krótkie URLe…

…zniknęły.

nie wczoraj, a pół roq temu, ale może komuś umknęło to tak, jak mi. chodzi o skrócone adresy URL, które dostępne były w różnych serwisach typu OneDrive czy Google Maps. z jednej strony co za różnica czy adres jest skrócony, przecież i tak się go nie uczymy na pamięć, tylko wysyłamy mailem czy innym medium, z drugiej strony miało to ciekawy efekt psychologiczny – taki krótki adres nie straszy. kiedy widzi się długi ciąg znaków w adresie, który mamy kliknąć to budzi niepoqj, w przeciwieństwie do krótkiego, zwięzłego. no i mimo wszystko, rzadko-bo-rzadko, ale czasem taki adres trzeba przedyktować przez telefon. dziwne przypadki się zdarzają.

zastanawiałem się, czemu serwisy Google czy MS wycofały tą usługę i okazuje się, że chodzi o bezpieczeństwo. jeśli udostępnialiście kiedyś pliki lub lokalizacje z usługi chmurowej, to wiecie, że całe bezpieczeństwo opiera się w właśnie na linq – w nim zawarty jest token, upoważniający do edycji lub odczytu pliq. to samo w sobie nie jest jeszcze tragedią, bo wysyłając link mailem musimy pamiętać, że może kiedyś trafić 'gdziekolwiek’ i doqment/lokalizacja będzie mógł być pobrany lub edytowany przez przypadkową osobę. większym problemem był fakt, że token w zawartym linq, oraz uporządkowana struktura serwisu pozwala na dostęp do innych danych.

całość, wraz z raportem na podstawie odkodowanych linqw można znaleźć w tym artyqle a dla leniwych, skrócona wersja przykładowych scenariuszy ataq:

  • dla OneDrive, znalezienie katalogu z zapisem, umożliwia łatwe wstrzyknięcie wirusa/malware na komputery użytkownika, ponieważ usługa ta daje możliwość synchronizacji katalogu, która jest powszechnie wykorzystywana. statystyki z badania pokazały, że aż 7% katalogów dawało możliwość zapisu [SIC!]
  • dla GMaps, wykrycie zapisanych przez użytkownika miejsc, daje możliwość bardzo dokładnego profilowania – w skrócie dostęp do informacji kim jesteśmy, gdzie bywamy, a nawet z kim się spotykamy – co daje podstawy do bardzo dobrze sprofilowanego ataku – czy to elektronicznego, czy IRL.

to w sumie oczywiste, ale przypomina, jak olbrzymia odpowiedzialność spoczywa na dostawcach usług globalnych. taki mały niuansik – ot, skrócony link…

w epoce 'chmury’ i wszechobecnego ułatwiania sobie życia, czasem zapominamy jak niebezpieczne jest udostępnianie danych. nie jestem zwolennikiem paranoidalnego odcinania się od usług… bo są wygodne. i dużo traci się na blokowaniu wszelkich ciasteczek, korzystania z map, backupu zdjęć czy trzymania doqmentów w chmurze. poszukiwanie niszowych rozwiązań, które są rzadziej kierunkiem ataq ze względu na mniejszą popularność, może być jakimś rozwiązaniem. ale traci się wtedy na integracji – decydując się na usługi jednego dostawcy, mamy tzw. 'suite’ czyli cały pakiet usług, pomiędzy którymi łatwo wymienia się dane, co daje olbrzymią elastyczność i wygodę.

wybór należy do Ciebie – byle świadomy!

eN.